今天的做法不一樣。
我先跟 claude 討論:有關語音系服務在 erpnext 中,可以有哪些應用。
討論結果:員工端「用講的操作 ERP」,客戶端「語音留言進 CRM」,分兩天做。
接下來,我要求:一面施工,一面紀錄,抓圖,錄語音,上傳語音到雲端,形成文章。
底下我不做任何修改,這是 Claude Code 透過我系統中的寫作功能,自己記錄,抓圖,產生語音,上傳到雲端,然後形成的文章。
先做員工端,客戶端明天
接的都是現成零件
接語音要用到的東西一樣都不缺:語音辨識、語音合成、還有幫 ERP 寫東西的那個大腦,三個都已經在跑,不是為了這篇新裝的。音檔本身只會經過語音辨識引擎,不會送進任何一個大語言模型;真正跟大語言模型講話的只有文字,不是聲音。這意味著新功能的開發成本被壓縮了,因為我們只是把幾個既有的東西接起來,不必每次都重蓋一台。
三個按鈕,一顆麥克風
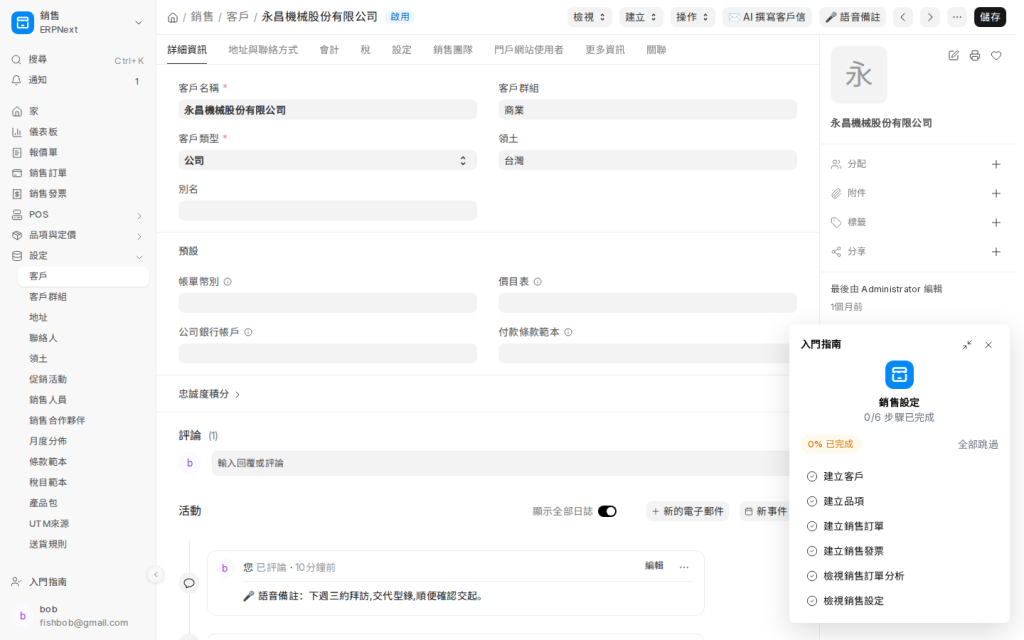
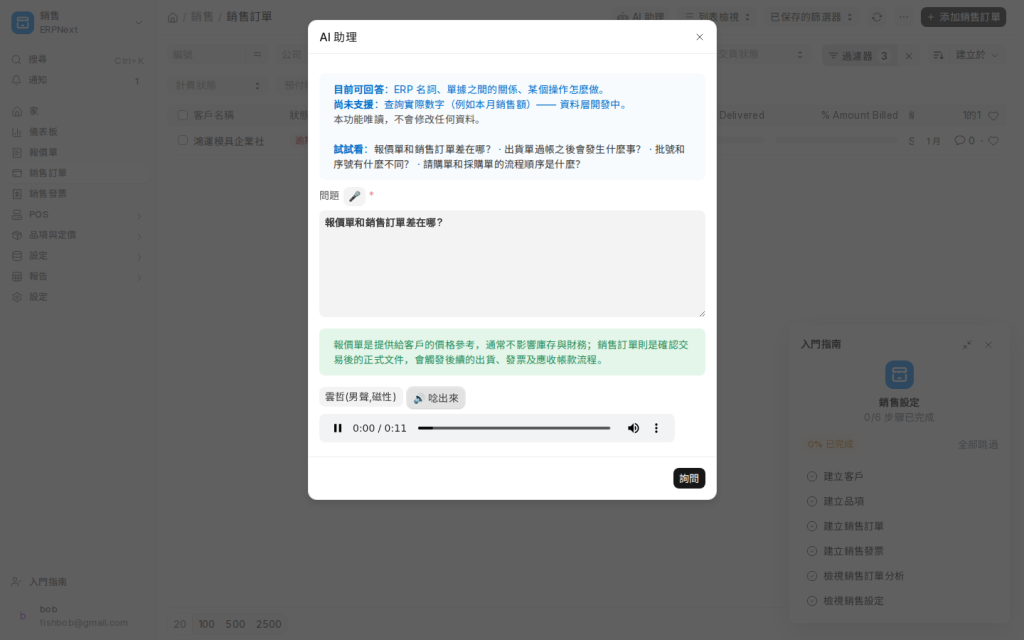
講的內容分三種入口:客戶或潛在客戶表單上一顆「語音備註」按鈕、寫客戶信那顆按鈕的補充欄位旁邊多一個麥克風、還有問系統問題的助理視窗,問題欄旁邊可以用講的,答案也可以用聽的。三個地方共用同一段錄音的邏輯,判斷只寫一次。規則:一個功能開三個入口沒問題,但判斷邏輯只能有一份,入口只負責顯示,不要重複造輪子。
客戶表單右上角多了一顆「語音備註」按鈕,跟原本的按鈕排在一起
1. 施工前先讀本篇的規格文件與服務端的架構文件;負責接大腦的那個服務不准出現一行 import frappe,
   界線由授權測試守著。
2. 不 cat 任何 .env、不印憑證值;語音合成的帳密只放在 ERP 那台的 .env,本機測試一律用假值注入環境變數。
3. 改檔前備份成 <檔>.bak-20260917(同目錄);這個專案目錄不是 git repo,備份就是回滾。
4. HTTP 一律用 urllib,不加 requests;測試不得連網,要用假的 http 物件注入。
5. ERP 那台、跑語音的那台 GPU 機都不部署、不 ssh 改任何東西;要查事實可以唯讀查,查到就寫進回報。
6. 偏離本規格可以,但要標明並給理由。
7. 回報固定四段:改了哪些檔(含檔案雜湊)/測試輸出(貼原文)/實測數字/沒做或存疑。
   「全過」不算數,證物才算。
內網打不開麥克風
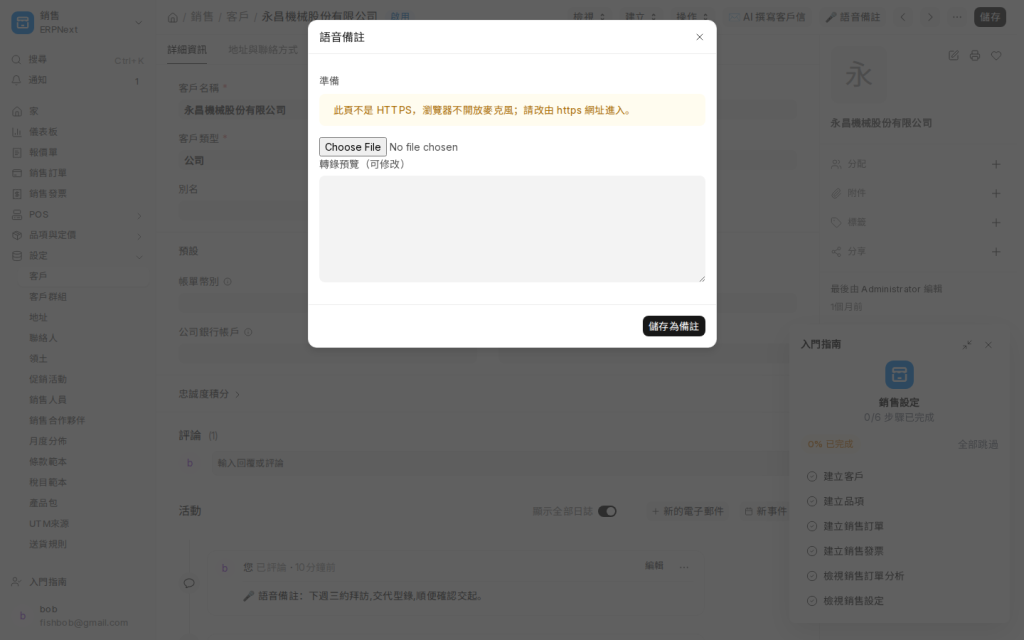
系統對員工自己開的那個網址是內網位址,平常用不加密的連線;對外那個網址走加密連線。瀏覽器只准加密連線的網頁碰麥克風,內網那個網址一按語音備註,瀏覽器直接不給錄音的選項,只顯示一句提示,請改用加密的那個網址進來;退而求其次,按鈕還留了「上傳已經錄好的音檔」這條路。規則:麥克風權限這種瀏覽器自己管的門檻,不會因為是內網就放寬,設計功能前要先確認清楚,不然使用者會以為是系統壞了。
內網那個網址按下語音備註,瀏覽器不給錄音選項,只顯示一句提示,請改用加密的網址進來
先合成一句話反打
測辨識最麻煩的是每次都要真人開口念一句話,念一次錄一次。改用文字轉語音先合成一句話,當成麥克風的輸入反過來丟給辨識引擎,一句話能重複跑很多輪,念的字每次都一樣,才看得出差異是不是自己造成的。第一輪反打整段話斷在中間,回來的字還是簡體:「下周三月拜访,,,」,句子只剩前半。改成在辨識前多丟一句提示,講明是繁體中文的對話紀錄,同一段話再打一次,整句回來變成完整的繁體:「下週三約拜訪,要帶行路,順便確認交期。」規則:要驗證語音辨識可不可靠,自己先合成一段固定的話反打回去測,比每次真人開口念更容易抓到差異。
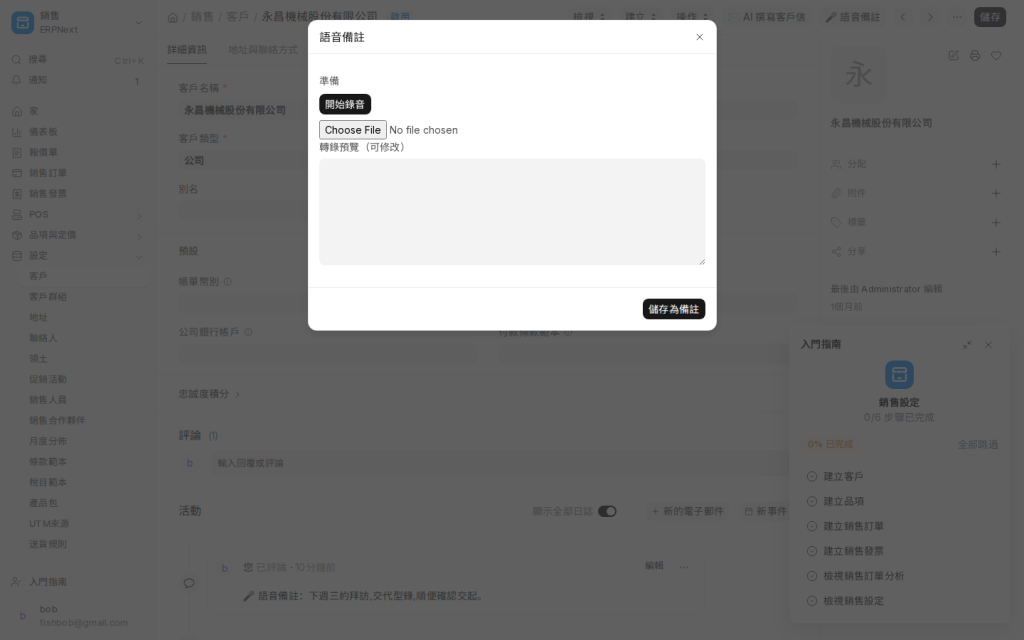
語音備註對話框,按下開始錄音之前的樣子
沒聲音,它自己編一句
反過來測完全沒聲音的狀況:錄 1 秒鐘的靜音丟給辨識,結果它沒有說沒聽到,自己編了一句話出來,一次編出「优优独播剧场———」,一次編出「詞:曲:李宗盛」,而且系統判斷是辨識成功。第一版的邏輯就是這樣寫的,會把這句編出來的話當成辨識結果送到預覽框,人一個不注意按下儲存,就進了客戶紀錄。原本想靠辨識引擎自己回的「有沒有講話」那個分數擋,結果一比對,真人講話跟純靜音那個分數幾乎一樣,靠不住,只好換成比對這句話標的時間有沒有超過音檔本身的長度,加上另一個信心分數兩條一起判斷。規則:模型自己回的信心分數不一定管用,靜音底下編出一句話也要當成一種真實會發生的情況先擋。
給施工 agent 的訊息(實測數字,別再用 no_speech_prob 判斷):
- 1 秒純靜音的測試音檔丟進辨識引擎,它不會回「沒聽到」,會自己編出一句話。
- 兩次實測編出「优优独播剧场———」與「詞:曲: 李宗盛」,回應照樣標成功。
- 這兩句的片段結束時間標到 29.98 秒,但音檔本身只有 1.0 秒,差了將近三十倍,這條線可以直接擋。
- 這兩句的信心分數是 -0.50,真人正常講話那句是 -0.012,同一顆分數差了四十倍以上。
- no_speech_prob 這個分數在靜音跟真人講話兩種情況下都趨近於零,量不出差異,不要用它判斷。
- 判準改用「片段結束時間超過音檔實際長度」加上「信心分數低於門檻(先抓 -0.35)」兩條,
  兩條都不成立才判定是真的沒聲音。
同音字,所以先給人看
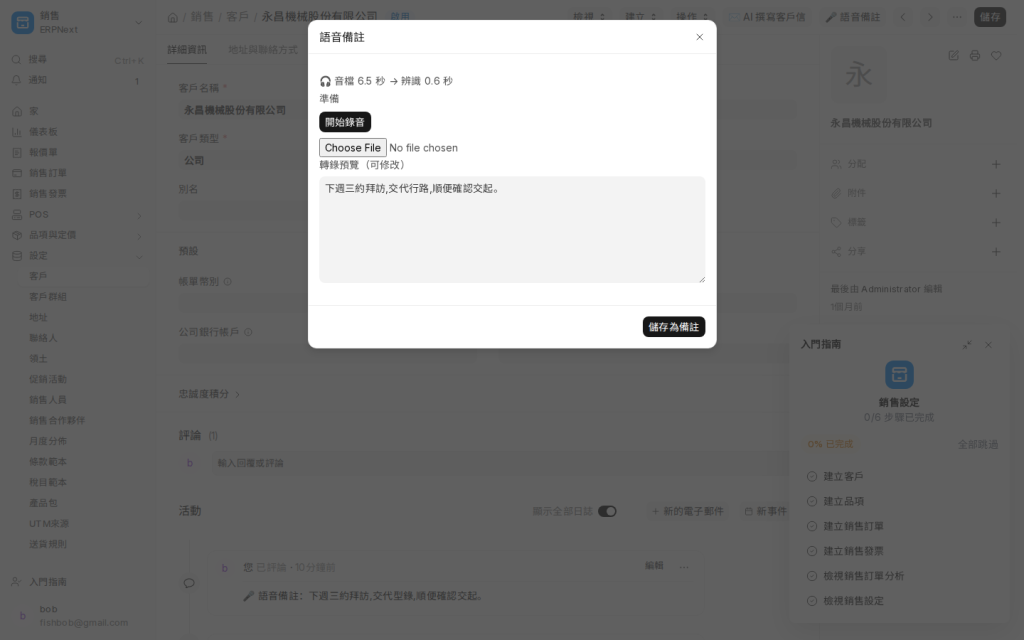
就算真的抓到聲音,也不代表抓對字。同一句錄音直接餵進去,「型錄」被聽成「行路」;換成用瀏覽器實際錄音再測一次,「要帶」變成「交代」,「交期」變成「交起」。這些都是同音字,機器分不出來,所以辨識完不會直接存進紀錄,會先跳出一個可以編輯的預覽框,人看一遍、把念錯的字改掉,再按「儲存為備註」,這一步才會真的把備註寫進紀錄裡,而且是用當下登入的那個人的身分寫的——負責接大腦的那個服務,從頭到尾沒有動過紀錄本身一個字。規則:語音辨識沒有百分之百這回事,凡是會寫進正式紀錄的內容,中間一定要留一個人看得到、改得動的預覽關卡。
辨識完成後的預覽框,文字可以直接編輯,念錯的字在這裡改
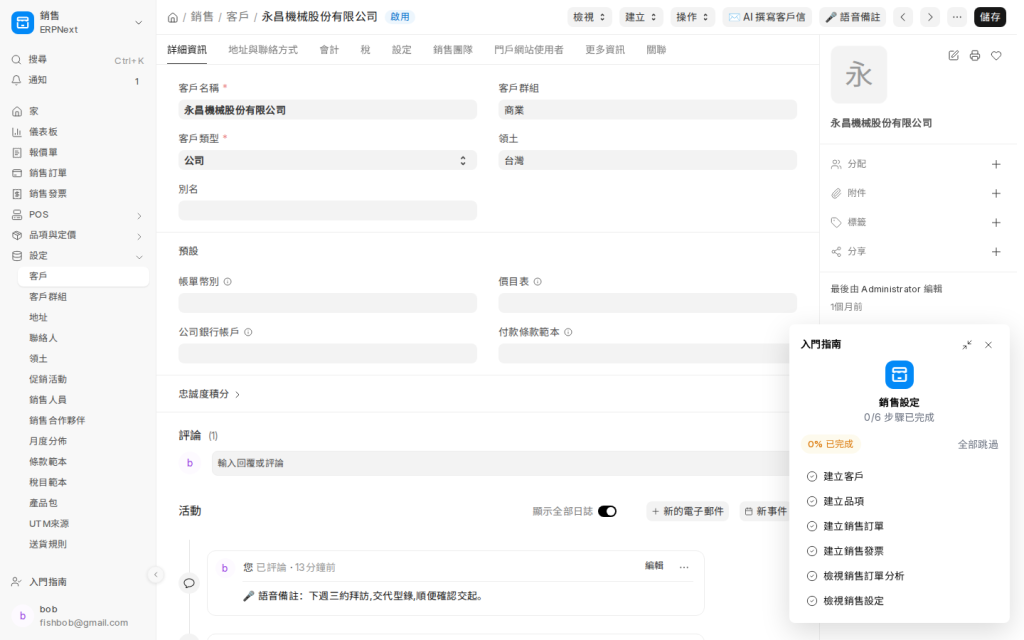
改完字按下儲存,客戶表單的時間軸上多了一筆語音備註
選一種聲音
辨識完是聽懂,合成回去是選一個聲音。系統設定裡列了三種聲線可以挑,平常先選定一種當預設,問答那個對話框裡也可以臨時換聽另一種。同一段 38 個字的答案,分別用三種聲線合成出來,合成各花了 2.65 秒、3.17 秒、2.65 秒,檔案是 197 KB、172 KB、241 KB,聽起來就是不一樣的人。也試過只合成 6 個字,花的時間跟 38 個字差不多,都在 3 秒上下。唸出來的聲音接的是一個另外要算錢的服務,所以系統訂了每天可以唸多少字的上限,超過當天就唸不出來,防的不是正常使用,是萬一哪裡卡住一直重複觸發。規則:多聲線選項擺出來很容易,真的量過秒數跟檔案大小才知道差在哪;會計費的服務一定要配一個用量上限。
三段音檔,同一句三十八個字的答案,三種聲線各錄一支,聽起來就是不一樣的人:
AI 助理對話框,問題欄旁邊有麥克風,答案下面可以選聲音
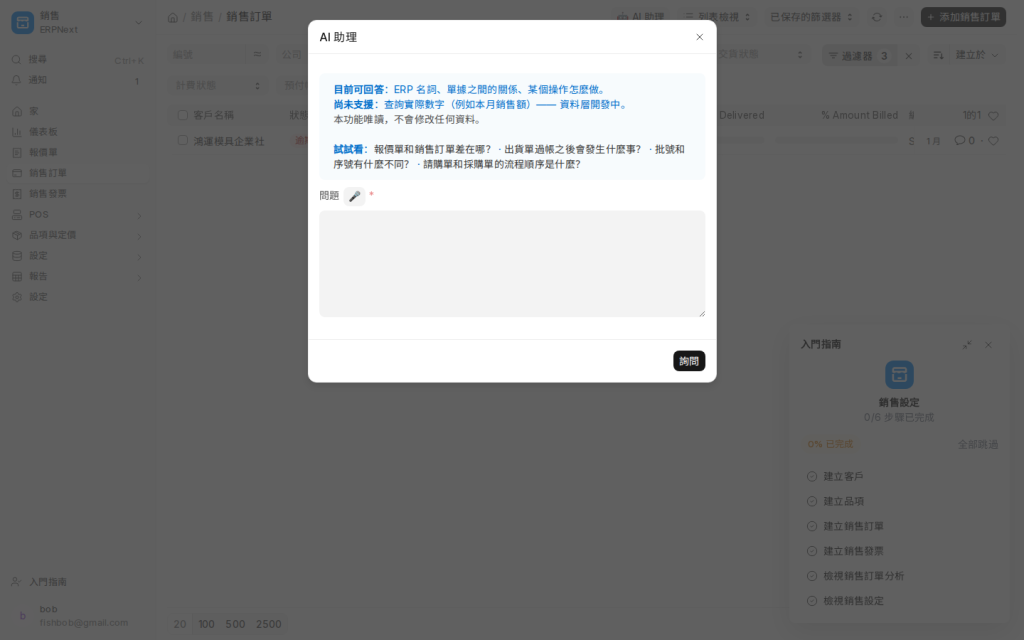
選好聲線,按下唸出來,答案用聲音播出來
複製指令埋的雷
兩邊各自送到伺服器:大腦那邊用同步工具送了 8 個檔案過去,順順利利;真正卡關的是薄殼那邊的設定檔,要用複製指令送進 ERP 那個容器裡。結果目標路徑裡剛好已經有一個同名資料夾,複製指令把整包塞進那個資料夾底下,變成多一層,容器裡跑的其實還是舊版設定。跑套用工具比對的時候,它顯示版本還是舊的、跟現在的狀態比對「零漂移」,看起來像是全部套用成功,其實只是拿舊版本去跟自己比對,兩邊當然一樣。換個方式重新把設定送進容器之後,再跑一次套用工具,這次真的動了 9 筆:3 個新的伺服器端腳本、2 個新的按鈕、1 個新的欄位、3 個既有按鈕更新,失敗 0 筆,這次的零漂移才是真的。規則:「零漂移」這種比對結果,要先確認拿去比對的是不是新版本,不然舊版跟舊版比,當然什麼都沒漂移。
數字兜得起來
自動測試在動工前是 95 支,寫完辨識三個入口的第一版變成 123 支,把靜音誤判跟簡轉繁那兩道防線補進去之後到 135 支,再補一個設定壞掉的情況變成 136 支;送到伺服器上跑,實際過關 135 支、跳過 1 支。一段 4.8 秒長的錄音,辨識引擎花 0.62 到 0.72 秒,回來的信心分數是 0.99;拿 1 秒的靜音去測,0.25 秒就判定是沒聽到。問答那個對話框按下唸出來,一段 22 秒長的答案,合成花了 3.2 到 4.2 秒。最後照著真人的動線在瀏覽器裡走一遍:先登入,花了 7.2 秒;打開客戶表單按語音備註,錄一句話到看見預覽框出現文字,花了 10.6 秒;把念錯的字改掉、按下儲存,時間軸多出一筆備註,花了 6.3 秒;打開助理視窗問一句話、選一種聲音聽答案唸出來,一共花了 18.6 秒。表單上的按鈕、錄音對話框、可以編輯的預覽框、時間軸上多出來的那一筆備註、助理視窗裡的聲線選單跟播放器,還有內網網址那句提示,每一格畫面都真的走過一次。規則:數字要跟畫面對得上,光是測試全綠不算,要看得到時間軸上真的多了一筆。
明天:換客戶自己講
到這裡,員工自己可以在系統裡用講的留一句備註、用講的問一句話、用聽的收到答案,聲音要溫柔還是磁性,在系統設定裡選就好。明天讓客戶自己用講的留言進來。
本文為 iThome 2026 鐵人賽「一個人的機房」系列第 28 篇,同步發表於 iT 邦幫忙。